ข้อสอบเก่า Final
แบบเปลี่ยนโจทย์ได้
อาจารย์บอกว่า Final จะออกเหมือนชุดนี้ แต่ปรับตัวเลข ย้ายสายเส้นนั้นเส้นนี้ หรือเปลี่ยนเลข operation — ทุกข้อในหน้านี้จึงมี เครื่องปั่นโจทย์ ให้เปลี่ยนเองได้ และทุกครั้งที่เปลี่ยนจะได้เฉลยกับคำอธิบายชุดใหม่ ฝึกจน “วิธีคิด” ติดมือ ไม่ใช่จำคำตอบ
ภาพรวมข้อสอบ
ห้ามนำเอกสารเข้าข้อสอบชุดนี้วัดอะไร
| ข้อ | เรื่อง | รูปแบบคำตอบ |
|---|---|---|
| 1 | บวกเลข 4 บิต signed/unsigned + overflow | ฐานสอง + True/False |
| 2 | ALU control: Ainv, Binv, CarryIn, Operation | ตาราง 0/1/x |
| 3 | Main control ของ multicycle 3 state | ตาราง 0/1 + next state |
| 4 | ต่อสาย datapath ของ srl กับ barrel shifter | วาดในกระดาษ |
| 5 | เวลา pipeline + ชื่อ hazard และวิธีแก้ | ตัวเลข + ศัพท์ |
| 6 | ทำไม stage หลัง ID ได้ control ถูกตัว | เขียนอธิบาย |
ข้อ 1–3 และ 5 ส่งคำตอบเข้า autolab · ข้อ 4 และ 6 เขียนในกระดาษ
วิธีใช้หน้านี้
- ดูโจทย์จริง ก่อนเสมอ — ทุกข้อแปะภาพจากข้อสอบไว้บนสุด กดที่ภาพเพื่อขยาย
- ปูพื้น (กดเปิด) — เนื้อหาเท่าที่ต้องใช้กับข้อนั้น ใครพร้อมแล้วข้ามได้
- วิธีคิด — ขั้นตอนที่ใช้ได้กับทุกเวอร์ชันของโจทย์ อันนี้คือของที่ต้องติดตัวเข้าห้องสอบ
- เครื่องปั่นโจทย์ — ลองตอบเอง กดตรวจ แล้วกด “สุ่มโจทย์ใหม่” วนไปจนตอบถูกโดยไม่ต้องดูเฉลย
หน้าแรกของข้อสอบคำสั่งและจุดประสงค์ของ FE2019bกดเพื่อเปิด
สอบครั้งที่ 2 เทอมปลาย ปีการศึกษา 2561 · 3 ชั่วโมง · ห้ามนำเอกสาร · อนุญาตเครื่องคิดเลข · ส่งคำตอบทาง autolab
คำถาม 1 — Computer arithmetic 4 บิต
10 คะแนน · ไม่มี partial credit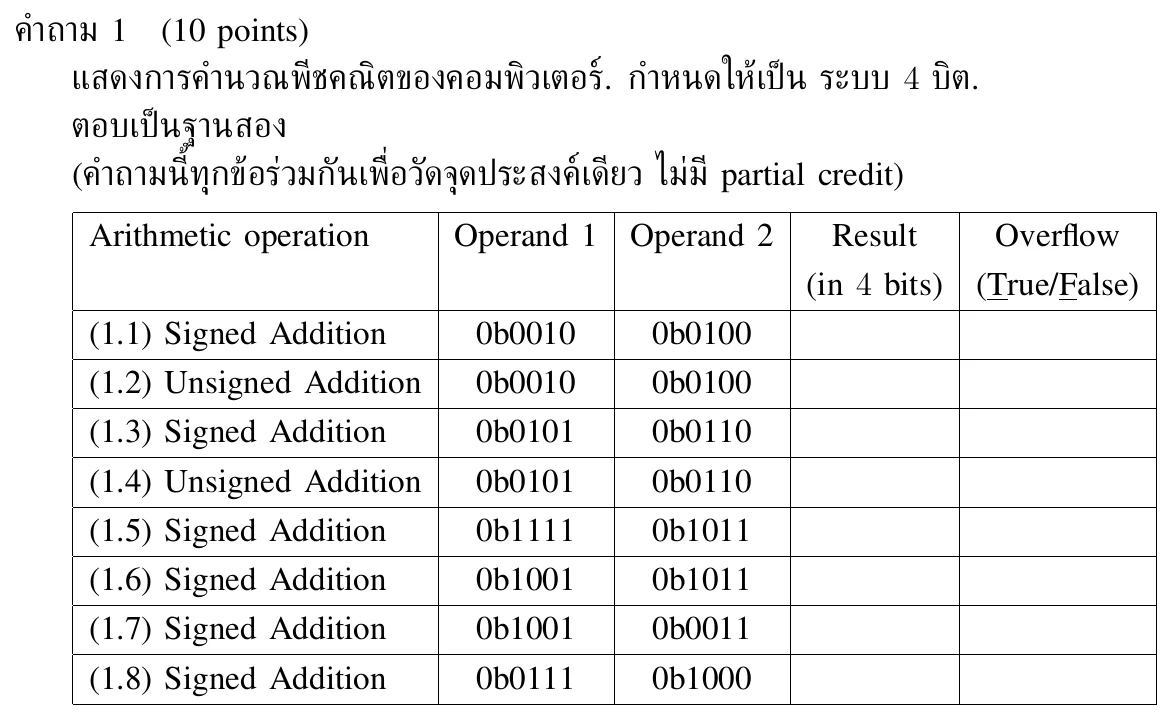
บวกเลข 4 บิต 8 ข้อ ตอบ Result 4 บิต และ Overflow — ข้อนี้ ไม่มี partial credit ผิดช่องเดียวเสียทั้งข้อ จุดที่คนพลาดบ่อยคือข้อที่ operand เหมือนกันแต่ชนิดต่างกัน (1.3 กับ 1.4) ซึ่ง Result เหมือนกันแต่ Overflow ไม่เหมือนกัน อาจารย์เปลี่ยนตัวเลขได้ง่ายที่สุดในข้อนี้ จึงต้องทำได้ทุกตัวเลข
ปูพื้นก่อนทำ: two’s complement และ overflowใครพร้อมแล้วข้ามได้
บิตชุดเดียว อ่านได้สองแบบ
เลข n บิตชุดเดียวกัน ถ้าอ่านแบบ unsigned จะได้ 0 ถึง 2n−1 ถ้าอ่านแบบ signed (two’s complement) บิตซ้ายสุดมีน้ำหนักเป็น −2n−1 จึงได้ช่วง −2n−1 ถึง 2n−1−1 — สำหรับ 4 บิตคือ 0…15 กับ −8…7
| บิต | unsigned | signed | บิต | unsigned | signed |
|---|---|---|---|---|---|
| 0000 | 0 | 0 | 1000 | 8 | −8 |
| 0001 | 1 | +1 | 1001 | 9 | −7 |
| 0010 | 2 | +2 | 1010 | 10 | −6 |
| 0011 | 3 | +3 | 1011 | 11 | −5 |
| 0100 | 4 | +4 | 1100 | 12 | −4 |
| 0101 | 5 | +5 | 1101 | 13 | −3 |
| 0110 | 6 | +6 | 1110 | 14 | −2 |
| 0111 | 7 | +7 | 1111 | 15 | −1 |
หาค่าลบเร็วๆ: กลับทุกบิตแล้ว +1 เช่น 1011 → 0100 + 1 = 0101 = 5 ⇒ 1011 = −5 · หรือคิดจากน้ำหนัก 1011 = −8 + 0 + 2 + 1 = −5
วงจรบวกตัวเดียว ใช้ได้ทั้งสองแบบ
ALU บวกเลขทีละบิตด้วย full adder ต่อกันเป็นทอด (ripple carry) — บิตผลลัพธ์ที่ออกมา ไม่สนว่าเป็น signed หรือ unsigned สิ่งที่ต่างกันมีแค่ การตีความ และ กฎตัดสิน overflow นี่คือเหตุผลที่ในโจทย์ 1.3 กับ 1.4 ช่อง Result ตอบเหมือนกันทุกบิต
Overflow คืออะไร
คือ “ค่าจริงของผลลัพธ์เก็บไม่ได้ใน n บิต” — วิธีตัดสินเปลี่ยนตามชนิดของการคำนวณ
| ชนิด | overflow เมื่อ | ดูจากฮาร์ดแวร์ |
|---|---|---|
| unsigned + | ผลจริง > 2n−1 | carry out ของบิตบนสุด = 1 |
| unsigned − | A < B (ติดลบ) | carry out = 0 (ต้องยืม) |
| signed + | บวก+บวก ได้ลบ หรือ ลบ+ลบ ได้บวก | carry เข้าบิตบนสุด ≠ carry ออก |
| signed − | บวก−ลบ ได้ลบ หรือ ลบ−บวก ได้บวก | carry เข้าบิตบนสุด ≠ carry ออก |
การลบ: ฮาร์ดแวร์ทำ A − B = A + (~B) + 1 คือกลับบิต B แล้วป้อน carry-in ตัวแรกเป็น 1 (นี่คือที่มาของ Binvert และ CarryIn ในข้อ 2)
เนื้อหาเต็มอยู่ในบท Arithmetic for computers I สไลด์หน้า 3–11
วิธีคิดที่ใช้ได้ทุกเวอร์ชันตัวเลขเปลี่ยน ขั้นตอนไม่เปลี่ยน
- อ่านชนิดของแต่ละแถวก่อน — Signed หรือ Unsigned, Addition หรือ Subtraction (ข้อสอบชอบวาง operand ชุดเดียวกันไว้สองแถวติดกันแต่คนละชนิด)
- บวกบิตตรงๆ จากขวาไปซ้ายพร้อม carry ถ้าเป็นการลบให้แปลงเป็น A + ~B + 1 ก่อน — เก็บแค่ 4 บิตล่าง นั่นคือ Result
- ตัดสิน overflow ตามชนิด — unsigned บวก: มี carry ล้นออกจากบิตที่ 4 ไหม · signed: ตัวตั้งเครื่องหมายเดียวกันแต่ผลกลับเครื่องหมายไหม
- ตรวจซ้ำด้วยเลขฐานสิบ — แปลงเป็นเลขจริง บวกกัน แล้วดูว่าอยู่ในช่วง 0…15 (unsigned) หรือ −8…7 (signed) ไหม ถ้าสองวิธีไม่ตรงกันแปลว่าคิดผิดตรงไหนสักที่
เฉลยข้อสอบจริงเทียบกับที่ทำเองก่อนนะ
| ข้อ | ชนิด | Op 1 + Op 2 | Result | Overflow | ทำไม |
|---|---|---|---|---|---|
| 1.1 | Signed | 0010 + 0100 | 0b0110 | False | +2 + +4 = +6 อยู่ใน −8…7 |
| 1.2 | Unsigned | 0010 + 0100 | 0b0110 | False | 2 + 4 = 6 ≤ 15 · carry out = 0 |
| 1.3 | Signed | 0101 + 0110 | 0b1011 | True | +5 + +6 = +11 เกิน 7 · บวก+บวก ได้บิตบนสุดเป็น 1 |
| 1.4 | Unsigned | 0101 + 0110 | 0b1011 | False | 5 + 6 = 11 ≤ 15 · บิตเหมือน 1.3 แต่ไม่ overflow |
| 1.5 | Signed | 1111 + 1011 | 0b1010 | False | −1 + −5 = −6 อยู่ในช่วง (carry out ทิ้งไป ไม่เกี่ยว) |
| 1.6 | Signed | 1001 + 1011 | 0b0100 | True | −7 + −5 = −12 ต่ำกว่า −8 · ลบ+ลบ ได้บวก |
| 1.7 | Signed | 1001 + 0011 | 0b1100 | False | −7 + +3 = −4 · ต่างเครื่องหมายไม่มีทาง overflow |
| 1.8 | Signed | 0111 + 1000 | 0b1111 | False | +7 + −8 = −1 |
ต้องจำเข้าห้องสอบ · ถ้าอาจารย์พลิกโจทย์
ช่วงตัวเลข
- 4 บิต: unsigned 0…15 · signed −8…7
- 8 บิต: 0…255 · −128…127
- 32 บิต: 0…4,294,967,295 · −2,147,483,648…2,147,483,647
- 1000 = −8 (ไม่มี +8) · 1111 = −1
กฎ overflow
- unsigned +: carry out = 1
- unsigned −: A < B
- signed +: เครื่องหมายเหมือนกัน แต่ผลกลับเครื่องหมาย
- signed (ทุกกรณี): Cin ของ MSB ≠ Cout ของ MSB
ถ้าเปลี่ยนโจทย์
- เป็น 8 บิต — กฎเดิมทุกข้อ แค่ช่วงเปลี่ยน
- เป็นการลบ — แปลงเป็น A + ~B + 1 ก่อน
- ให้ operand เป็น hex — แปลงเป็นฐานสองก่อน (0xB = 1011)
- ถามว่า MIPS ทำอะไรตอน overflow —
add/addi/subเกิด exception ·addu/addiu/subuไม่สนใจ
คำถาม 2 — ALU control
10 คะแนน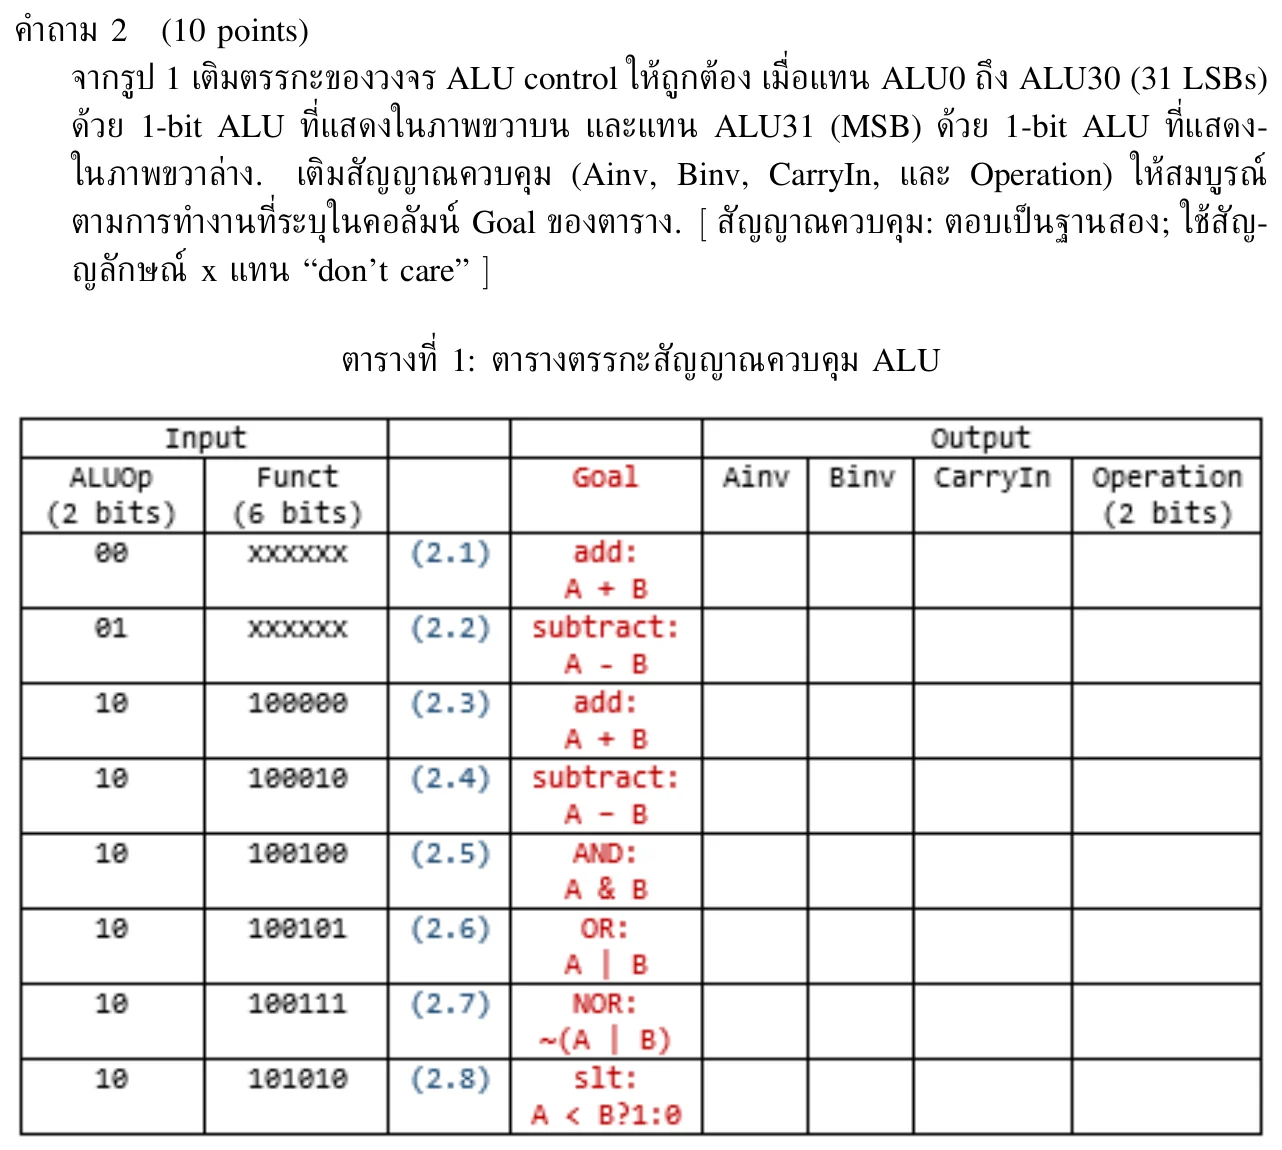
ให้เติม Ainv, Binv, CarryIn, Operation ของ ALU ในรูปที่ 1 ให้ทำงานตาม Goal แต่ละแถว · ตอบเป็นฐานสอง ใช้ x แทน don’t care — ข้อนี้อาจารย์บอกชัดว่าอาจย้ายสายในรูป เช่น สลับว่าขาไหนของ MUX ต่อกับอะไร ดังนั้นห้ามท่องเลข ต้องอ่านรูปทุกครั้ง
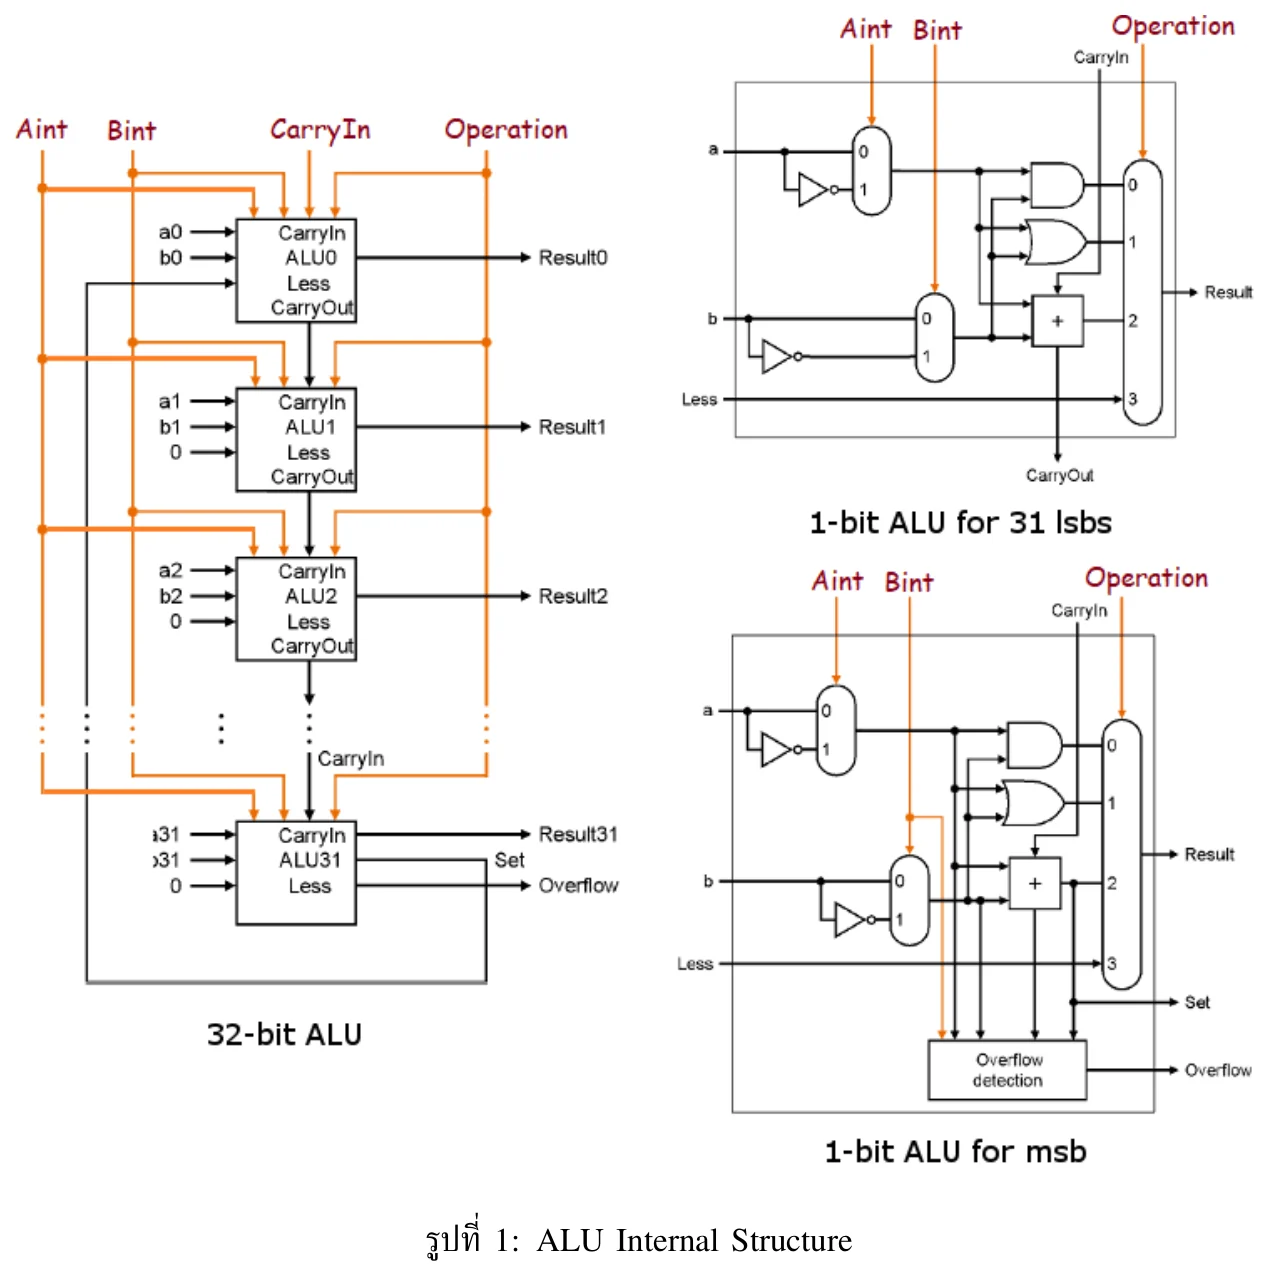
ปูพื้นก่อนทำ: ข้างในของ 1-bit ALUใครพร้อมแล้วข้ามได้
ชิ้นส่วนใน 1-bit ALU (รูปขวาบน)
- MUX ของ a — เลือกว่าจะส่ง
aหรือ~aต่อไป คุมด้วย Ainvert (ในข้อสอบเขียนว่า Aint) - MUX ของ b — เลือก
bหรือ~bคุมด้วย Binvert - ค่าที่ผ่าน MUX แล้ว (เรียก a′, b′) วิ่งเข้า AND gate, OR gate และ adder พร้อมกันทั้งสามตัว — ทุกตัวคำนวณตลอดเวลา
- MUX ผลลัพธ์ 4 ขา คุมด้วย Operation 2 บิต เลือกว่าจะเอาผลจากตัวไหนออกไปเป็น Result — ในข้อสอบ 0 = AND, 1 = OR, 2 = adder, 3 = Less
- Less — ขาพิเศษสำหรับ slt ของ ALU0 รับ Set (บิตเครื่องหมายจาก adder ของ ALU31) ส่วน ALU1–ALU31 ต่อ Less เป็น 0
ต่อ 32 ตัวเป็น ALU 32 บิต (รูปซ้าย)
CarryOut ของบิต i ต่อเข้า CarryIn ของบิต i+1 (ripple carry) — สายควบคุม CarryIn ที่ต้องตอบในตารางคือ CarryIn ของ ALU0 เท่านั้น ส่วน Ainvert, Binvert, Operation ต่อขนานเข้าทุกบิต ทุกบิตจึงทำ operation เดียวกัน
สามสูตรที่ทำให้ ALU ทำได้มากกว่า AND/OR/+
| อยากได้ | เขียนใหม่เป็น | ตั้งค่า |
|---|---|---|
| A − B | A + (~B) + 1 | Binvert = 1, CarryIn = 1, เลือก adder |
| NOR ~(A | B) | (~A) & (~B) — De Morgan | Ainvert = 1, Binvert = 1, เลือก AND |
| slt (A < B ? 1 : 0) | ดูเครื่องหมายของ A − B | ทำแบบลบ แล้วเลือกขา Less |
เชื่อมกับ ALU control 4 บิตในสไลด์
สไลด์บท Datapath I ให้ ALU control เป็น 4 บิต: and = 0000, or = 0001, add = 0010, sub = 0110, slt = 0111, nor = 1100 — จริงๆ แล้ว 4 บิตนี้คือ [Ainvert | Bnegate | Operation 2 บิต] โดย Bnegate คือ Binvert กับ CarryIn ที่ต่อเป็นสายเดียวกัน ข้อสอบชุดนี้แยก CarryIn ออกมาเป็นอีกสาย เลยต้องตอบสี่ช่อง
don’t care ใส่ตรงไหนได้บ้าง
ช่องไหน “ไม่ว่าจะเป็น 0 หรือ 1 Result ก็เหมือนเดิม” ใส่ x — ในวงจรนี้มีแค่ CarryIn ตอนที่ไม่ได้เลือก adder (AND, OR, NOR) · ส่วน Ainvert/Binvert ห้ามเป็น x เพราะทุก operation ใช้ a′ และ b′
เนื้อหาเต็มอยู่ในบท Arithmetic for computers I สไลด์หน้า 27–34 และ Datapath and control I หน้า 25–28
วิธีคิดที่ใช้ได้ทุกเวอร์ชันอาจารย์ย้ายสายได้ ขั้นตอนนี้ไม่เปลี่ยน
- แปลง Goal เป็นสูตรของ ALU — เขียนให้อยู่ในรูป a′ ⊙ b′ (+ carry) เมื่อ a′ ∈ {a, ~a}, b′ ∈ {b, ~b} และ ⊙ คือ AND, OR, + หรือ Less เช่น NOR → ~a AND ~b
- ไล่สาย MUX ของ a และ b ในรูป — ดูว่าสายที่มีตัวกลับบิต (สามเหลี่ยม + วงกลม) เข้าขา 0 หรือขา 1 แล้วตอบ Ainv/Binv เป็นเลขขาที่ต้องการ
- ไล่สายเข้า MUX ผลลัพธ์ — ตัวที่ต้องใช้ต่อเข้าขาเลขอะไร เขียนเลขนั้นเป็นฐานสอง 2 บิต = Operation
- CarryIn — ใช้ adder และต้อง +1 → 1 · ใช้ adder ไม่ต้อง +1 → 0 · ไม่ได้ใช้ adder → x · slt ใช้ adder เสมอ (Set มาจาก adder) จึงต้องเป็น 1
- เช็กว่ามีสายต่อรวมกันไหม — ถ้า CarryIn ต่อกับ Binvert เป็นเส้นเดียว ก็ตอบค่าเดียวกัน (และบาง Goal เช่น B − A จะทำไม่ได้)
เฉลยข้อสอบจริง (วงจรตามรูปที่ 1)0 = AND · 1 = OR · 2 = + · 3 = Less
| ข้อ | ALUOp | Funct | Goal | Ainv | Binv | CarryIn | Operation |
|---|---|---|---|---|---|---|---|
| 2.1 | 00 | xxxxxx | add | 0 | 0 | 0 | 10 |
| 2.2 | 01 | xxxxxx | subtract | 0 | 1 | 1 | 10 |
| 2.3 | 10 | 100000 | add | 0 | 0 | 0 | 10 |
| 2.4 | 10 | 100010 | subtract | 0 | 1 | 1 | 10 |
| 2.5 | 10 | 100100 | AND | 0 | 0 | x | 00 |
| 2.6 | 10 | 100101 | OR | 0 | 0 | x | 01 |
| 2.7 | 10 | 100111 | NOR | 1 | 1 | x | 00 |
| 2.8 | 10 | 101010 | slt | 0 | 1 | 1 | 11 |
ต้องจำเข้าห้องสอบ · ถ้าอาจารย์พลิกโจทย์
สูตรของแต่ละ Goal
- add: a + b + 0
- sub: a + ~b + 1
- AND / OR: a, b ตรงๆ
- NOR: ~a AND ~b
- NAND: ~a OR ~b
- slt: ทำแบบ sub แล้วเลือก Less
กฎ x (don’t care)
- CarryIn = x เมื่อไม่ได้เลือก adder และไม่ใช่ slt
- Ainv / Binv แทบไม่เคยเป็น x
- Operation ไม่มีวันเป็น x
ถ้าเปลี่ยนโจทย์
- สลับขา MUX ผลลัพธ์ → Operation = เลขขาใหม่
- ตัวกลับบิตย้ายไปขา 0 → Ainv/Binv กลับค่า
- CarryIn ต่อกับ Binvert → ตอบเท่ากัน
- Goal ใหม่ B − A → Ainv = 1, Binv = 0, CarryIn = 1, เลือก adder
- ถามว่าทำไม beq ใช้ ALU ลบ → A − B = 0 ⇔ A = B ดูที่ Zero
คำถาม 3 — Main control ของ multicycle machine
10 คะแนน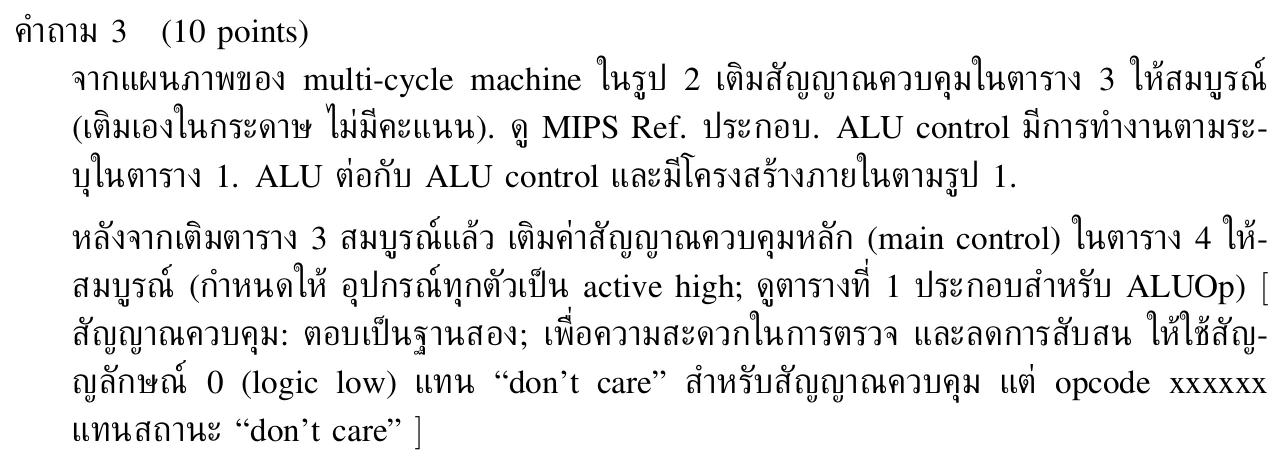
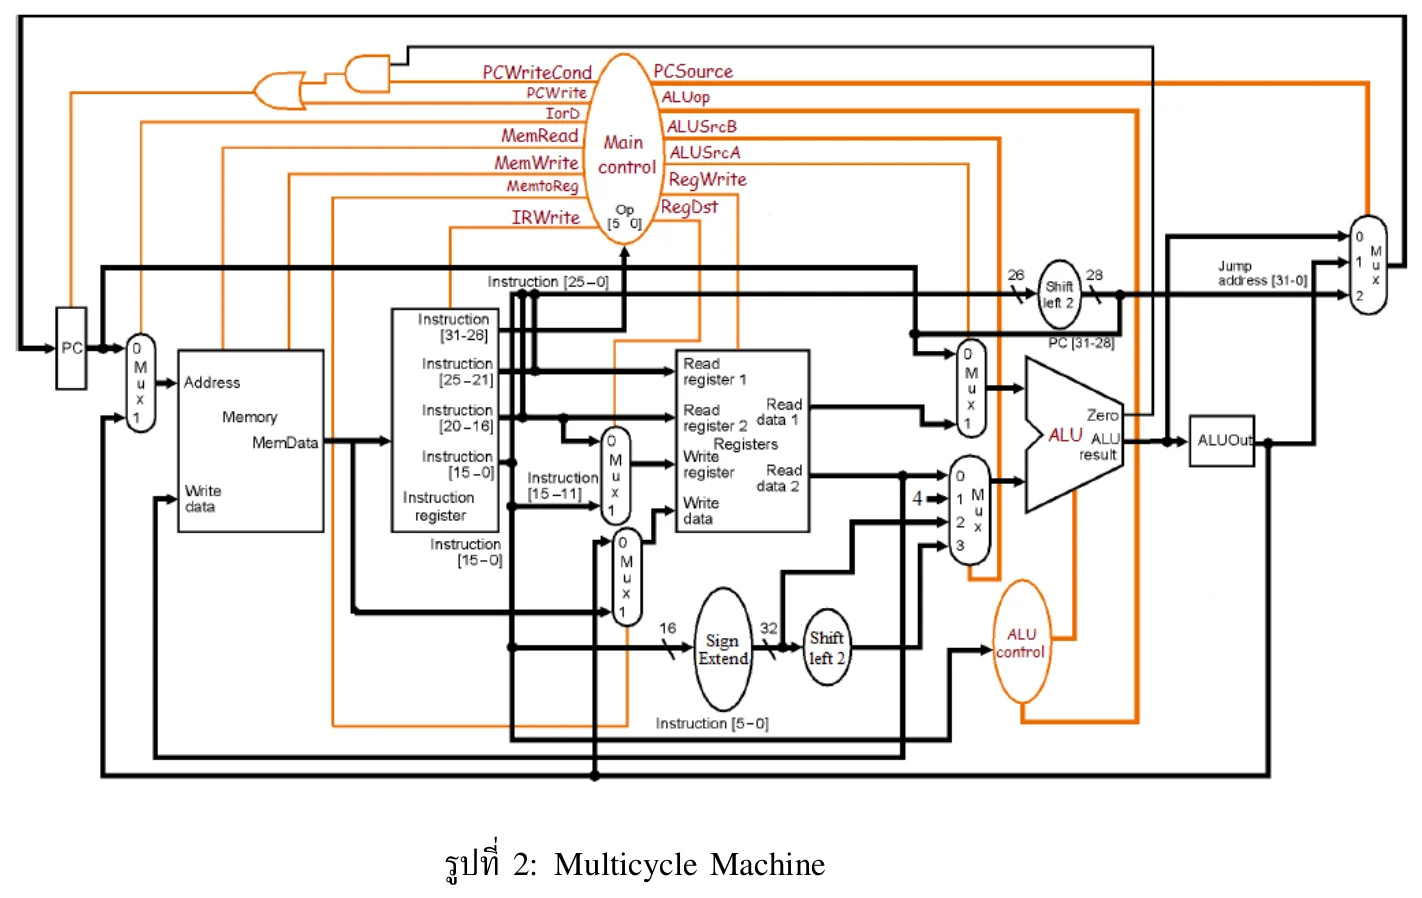
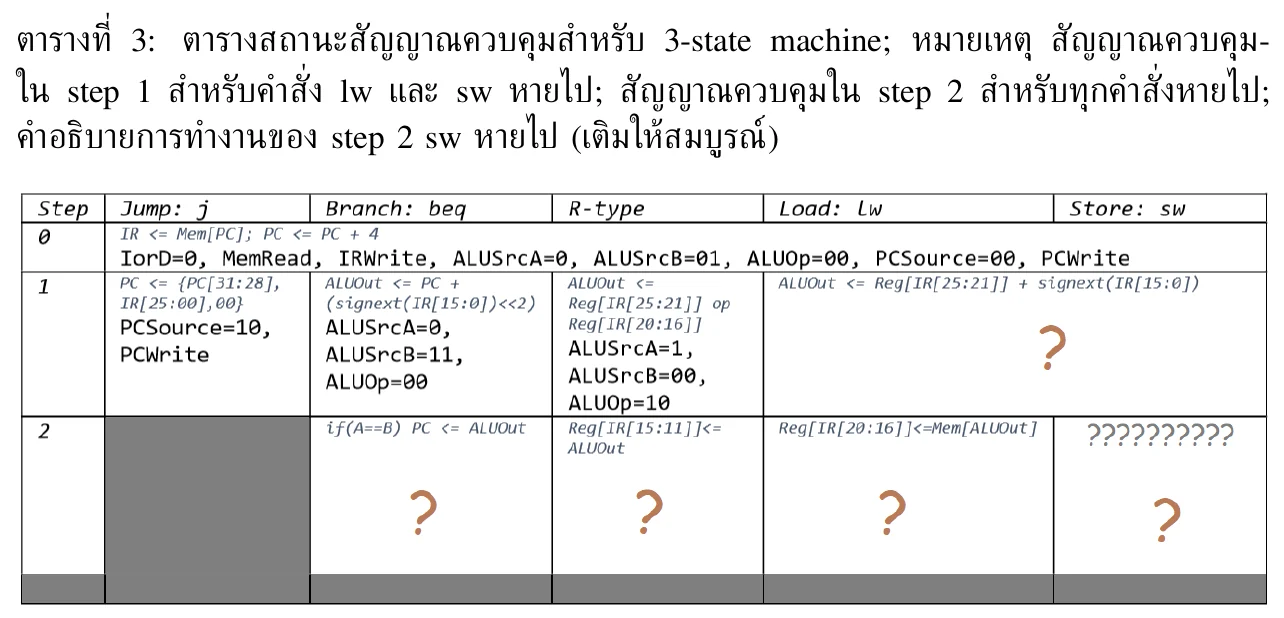
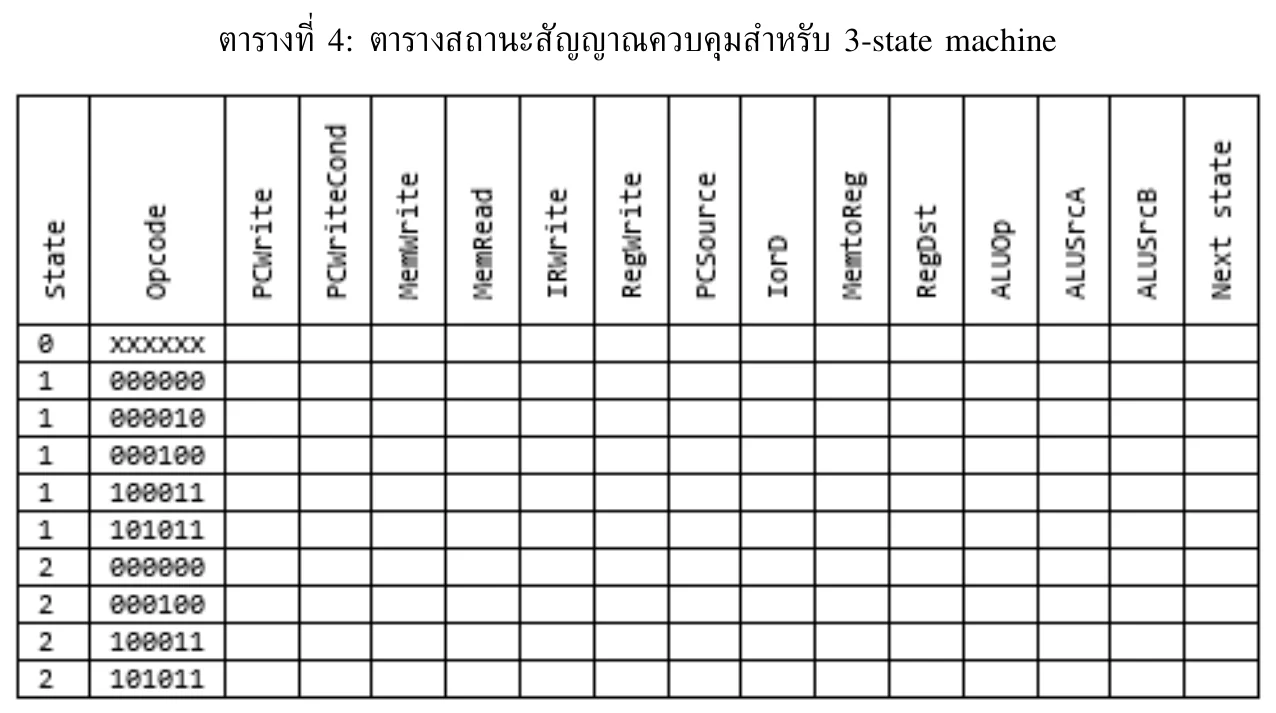
ข้อนี้มีสองตาราง — ตาราง 3 คือ RTL ของแต่ละ state (เติมเองในกระดาษ ไม่มีคะแนน แต่เป็นทางไปสู่คำตอบ) และ ตาราง 4 คือค่าสัญญาณควบคุมทุกเส้นของ main control (มีคะแนน) · ใช้ 0 แทน don’t care ของสัญญาณ แต่ opcode ใช้ xxxxxx — ถ้าอาจารย์ย้ายสายเข้า MUX หรือเปลี่ยนรหัส ALUOp ตัวเลขในตารางจะเปลี่ยนทั้งหมด จึงต้องคิดจากรูปทุกครั้ง
ปูพื้นก่อนทำ: multicycle machine ทำงานยังไงใครพร้อมแล้วข้ามได้
ทำไมต้อง multicycle
single-cycle machine ทำหนึ่งคำสั่งจบในหนึ่ง clock ทำให้ clock ต้องยาวเท่าคำสั่งที่ช้าที่สุด (lw) และต้องมี adder กับ memory หลายชุด · multicycle แบ่งคำสั่งเป็นหลายขั้น ขั้นละหนึ่ง clock ใช้ ALU ตัวเดียวและ memory ตัวเดียวซ้ำได้ในคนละ clock โดยมี register ภายในอย่าง IR และ ALUOut คอยเก็บผลระหว่างขั้น
เวอร์ชัน 3 state ในข้อสอบ
| State | ทำอะไร | ใช้กับ |
|---|---|---|
| 0 | fetch: IR ← Mem[PC] และ PC ← PC + 4 พร้อมกัน | ทุกคำสั่ง (เหมือนกันหมด) |
| 1 | คำนวณหลัก: ผลของ ALU เก็บลง ALUOut (หรือ j เขียน PC แล้วจบเลย) | แยกตาม opcode |
| 2 | ปิดงาน: เขียน register / อ่าน-เขียน memory / beq ตัดสินว่าจะกระโดดไหม | ทุกคำสั่งยกเว้น j |
เพราะไม่มี A, B, MDR ค่าจาก register file จึงวิ่งตรงเข้า ALU ได้เลย และ lw อ่าน memory แล้วเขียนลง register ได้ใน state 2 รอบเดียว
สัญญาณแต่ละเส้นทำอะไร
| สัญญาณ | ชนิด | หน้าที่ |
|---|---|---|
| PCWrite | write enable | เขียน PC แน่ๆ (fetch, j) |
| PCWriteCond | write enable | เขียน PC เฉพาะเมื่อ ALU ให้ Zero = 1 (beq) |
| MemRead / MemWrite | enable | อ่าน/เขียนหน่วยความจำ |
| IRWrite | write enable | เก็บคำสั่งที่อ่านได้ลง IR (มีแค่ตอน fetch) |
| RegWrite | write enable | เขียน register file |
| IorD | MUX 2 ขา | address ของ memory มาจาก PC (คำสั่ง) หรือ ALUOut (ข้อมูล) |
| ALUSrcA | MUX 2 ขา | ALU ขา A = PC หรือ Reg[rs] |
| ALUSrcB | MUX 4 ขา | ALU ขา B = Reg[rt], 4, signext, signext<<2 |
| ALUOp | 2 บิต | บอก ALU control ว่าให้บวก ลบ หรือดู funct (ตาราง 1) |
| PCSource | MUX 3 ขา | PC ใหม่ = ผล ALU สด, ALUOut, หรือ jump address |
| RegDst | MUX 2 ขา | register ปลายทาง = rt (I-type) หรือ rd (R-type) |
| MemtoReg | MUX 2 ขา | ข้อมูลที่เขียนลง register = ALUOut หรือข้อมูลจาก memory |
ALU result กับ ALUOut ต่างกันยังไง
ALU result คือค่าที่ ALU กำลังคำนวณ ใน clock นี้ · ALUOut คือค่าที่ ALU คำนวณไว้ เมื่อ clock ก่อน — fetch ใช้ ALU result (PC+4 คำนวณเสร็จใน clock เดียวกัน) แต่ beq ใช้ ALUOut เพราะ branch target ถูกคำนวณไว้ตั้งแต่ state 1
เนื้อหาเต็มอยู่ในบท Datapath and control II สไลด์หน้า 2–8
วิธีคิดที่ใช้ได้ทุกเวอร์ชันย้ายสาย/เปลี่ยน ALUOp ก็ใช้ขั้นตอนนี้
- เขียน RTL ของรอบนั้นก่อน (คือตาราง 3) — เช่น lw state 2: Reg[IR[20:16]] ← Mem[ALUOut]
- ไล่ข้อมูลทีละก้อนใน RTL ว่าวิ่งผ่าน MUX ตัวไหน — address ของ Mem มาจาก ALUOut ⇒ ดูในรูปว่า ALUOut เข้าขาไหนของ IorD ⇒ ตอบเลขขานั้น (MUX 4 ขาตอบ 2 บิต)
- เปิด write enable ของของที่ถูกเขียนตอนจบรอบ — PC, IR, register file, memory · อ่าน memory ให้เปิด MemRead
- ALUOp — ใช้รหัสจากตาราง 1 ของข้อสอบ (ชุดนี้ 00 = บวก, 01 = ลบ, 10 = ดู funct) ถ้าโจทย์เปลี่ยนรหัสก็ใช้รหัสใหม่
- ที่เหลือทั้งหมดใส่ 0 แล้วเติม Next state — j จบที่ state 1 (กลับ 0) · คำสั่งอื่นไป 2 แล้วกลับ 0
เฉลยข้อสอบจริง (วงจรตามรูปที่ 2)ตัวหนา = ค่าที่ “ตั้งใจ” ใส่ · ตัวจาง = 0 แทน don’t care
ตาราง 3 ที่เติมครบ
| Step | j | beq | R-type | lw | sw |
|---|---|---|---|---|---|
| 0 | IR ← Mem[PC]; PC ← PC + 4 IorD=0, MemRead, IRWrite, ALUSrcA=0, ALUSrcB=01, ALUOp=00, PCSource=00, PCWrite | ||||
| 1 | PC ← {PC[31:28], IR[25:0], 00} PCSource=10, PCWrite | ALUOut ← PC + (signext(IR[15:0]) << 2) ALUSrcA=0, ALUSrcB=11, ALUOp=00 | ALUOut ← Reg[rs] op Reg[rt] ALUSrcA=1, ALUSrcB=00, ALUOp=10 | ALUOut ← Reg[rs] + signext(IR[15:0]) ALUSrcA=1, ALUSrcB=10, ALUOp=00 | |
| 2 | — | if (A == B) PC ← ALUOut ALUSrcA=1, ALUSrcB=00, ALUOp=01, PCSource=01, PCWriteCond | Reg[IR[15:11]] ← ALUOut RegDst=1, MemtoReg=0, RegWrite | Reg[IR[20:16]] ← Mem[ALUOut] IorD=1, MemRead, RegDst=0, MemtoReg=1, RegWrite | Mem[ALUOut] ← Reg[IR[20:16]] IorD=1, MemWrite |
ตาราง 4 (คำตอบที่ส่ง)
| State | Opcode | PCWrite | PCWriteCond | MemWrite | MemRead | IRWrite | RegWrite | PCSource | IorD | MemtoReg | RegDst | ALUOp | ALUSrcA | ALUSrcB | Next |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | xxxxxx | 1 | 0 | 0 | 1 | 1 | 0 | 00 | 0 | 0 | 0 | 00 | 0 | 01 | 1 |
| 1 | 000000 | 0 | 0 | 0 | 0 | 0 | 0 | 00 | 0 | 0 | 0 | 10 | 1 | 00 | 2 |
| 1 | 000010 | 1 | 0 | 0 | 0 | 0 | 0 | 10 | 0 | 0 | 0 | 00 | 0 | 00 | 0 |
| 1 | 000100 | 0 | 0 | 0 | 0 | 0 | 0 | 00 | 0 | 0 | 0 | 00 | 0 | 11 | 2 |
| 1 | 100011 | 0 | 0 | 0 | 0 | 0 | 0 | 00 | 0 | 0 | 0 | 00 | 1 | 10 | 2 |
| 1 | 101011 | 0 | 0 | 0 | 0 | 0 | 0 | 00 | 0 | 0 | 0 | 00 | 1 | 10 | 2 |
| 2 | 000000 | 0 | 0 | 0 | 0 | 0 | 1 | 00 | 0 | 0 | 1 | 00 | 0 | 00 | 0 |
| 2 | 000100 | 0 | 1 | 0 | 0 | 0 | 0 | 01 | 0 | 0 | 0 | 01 | 1 | 00 | 0 |
| 2 | 100011 | 0 | 0 | 0 | 1 | 0 | 1 | 00 | 1 | 1 | 0 | 00 | 0 | 00 | 0 |
| 2 | 101011 | 0 | 0 | 1 | 0 | 0 | 0 | 00 | 1 | 0 | 0 | 00 | 0 | 00 | 0 |
ต้องจำเข้าห้องสอบ · ถ้าอาจารย์พลิกโจทย์
RTL 3 state
- S0: IR ← Mem[PC]; PC ← PC+4
- S1 R: ALUOut ← rs op rt
- S1 lw/sw: ALUOut ← rs + signext
- S1 beq: ALUOut ← PC + signext<<2
- S1 j: PC ← jump address
- S2 R: rd ← ALUOut · lw: rt ← Mem[ALUOut]
- S2 sw: Mem[ALUOut] ← rt · beq: if equal PC ← ALUOut
เลขขา MUX ตามรูปข้อสอบ
- IorD: 0 PC · 1 ALUOut
- ALUSrcA: 0 PC · 1 Reg[rs]
- ALUSrcB: 0 Reg[rt] · 1 ค่า 4 · 2 signext · 3 signext<<2
- PCSource: 0 ALU · 1 ALUOut · 2 jump
- RegDst: 0 rt · 1 rd · MemtoReg: 0 ALUOut · 1 Mem
ถ้าเปลี่ยนโจทย์
- ย้ายสายเข้า MUX → เปลี่ยนแค่ช่องของ MUX ตัวนั้น
- เปลี่ยนรหัส ALUOp → เปลี่ยนแค่คอลัมน์ ALUOp
- เพิ่ม addi → S1 เหมือน lw · S2: RegDst = rt, MemtoReg = ALUOut, RegWrite
- ให้เครื่อง 5 state (มี A, B, MDR) → ดูตารางด้านล่าง
เผื่อเจอเวอร์ชัน 5 state (สไลด์ “Five-Stage Control”)
| Step | R-type | lw | sw | beq | j |
|---|---|---|---|---|---|
| 1 | IR ← Mem[PC]; PC ← PC+4 — IorD=0, MemRead, IRWrite, ALUSrcA=0, ALUSrcB=01, ALUOp=00, PCSource=00, PCWrite | ||||
| 2 | A ← Reg[rs]; B ← Reg[rt]; ALUOut ← PC + (signext << 2) — ALUSrcA=0, ALUSrcB=11, ALUOp=00 (คิดเผื่อ beq ไว้ก่อนทุกคำสั่ง) | ||||
| 3 | ALUOut ← A op B ALUSrcA=1, ALUSrcB=00, ALUOp=10 | ALUOut ← A + signext ALUSrcA=1, ALUSrcB=10, ALUOp=00 | if (A==B) PC ← ALUOut ALUSrcA=1, ALUSrcB=00, ALUOp=01, PCSource=01, PCWriteCond | PC ← jump address PCSource=10, PCWrite | |
| 4 | Reg[rd] ← ALUOut RegDst=1, MemtoReg=0, RegWrite | MDR ← Mem[ALUOut] IorD=1, MemRead | Mem[ALUOut] ← B IorD=1, MemWrite | — | — |
| 5 | — | Reg[rt] ← MDR RegDst=0, MemtoReg=1, RegWrite | — | — | — |
ความต่างหลัก: 5 state มี register A, B, MDR คั่น ทำให้แต่ละขั้นสั้นลง (clock เร็วขึ้น) แต่ใช้จำนวน clock มากกว่า — R-type 4, lw 5, sw 4, beq 3, j 3 clock
คำถาม 4 — ต่อ datapath ของ srl กับ barrel shifter
10 คะแนน · เขียนในกระดาษ
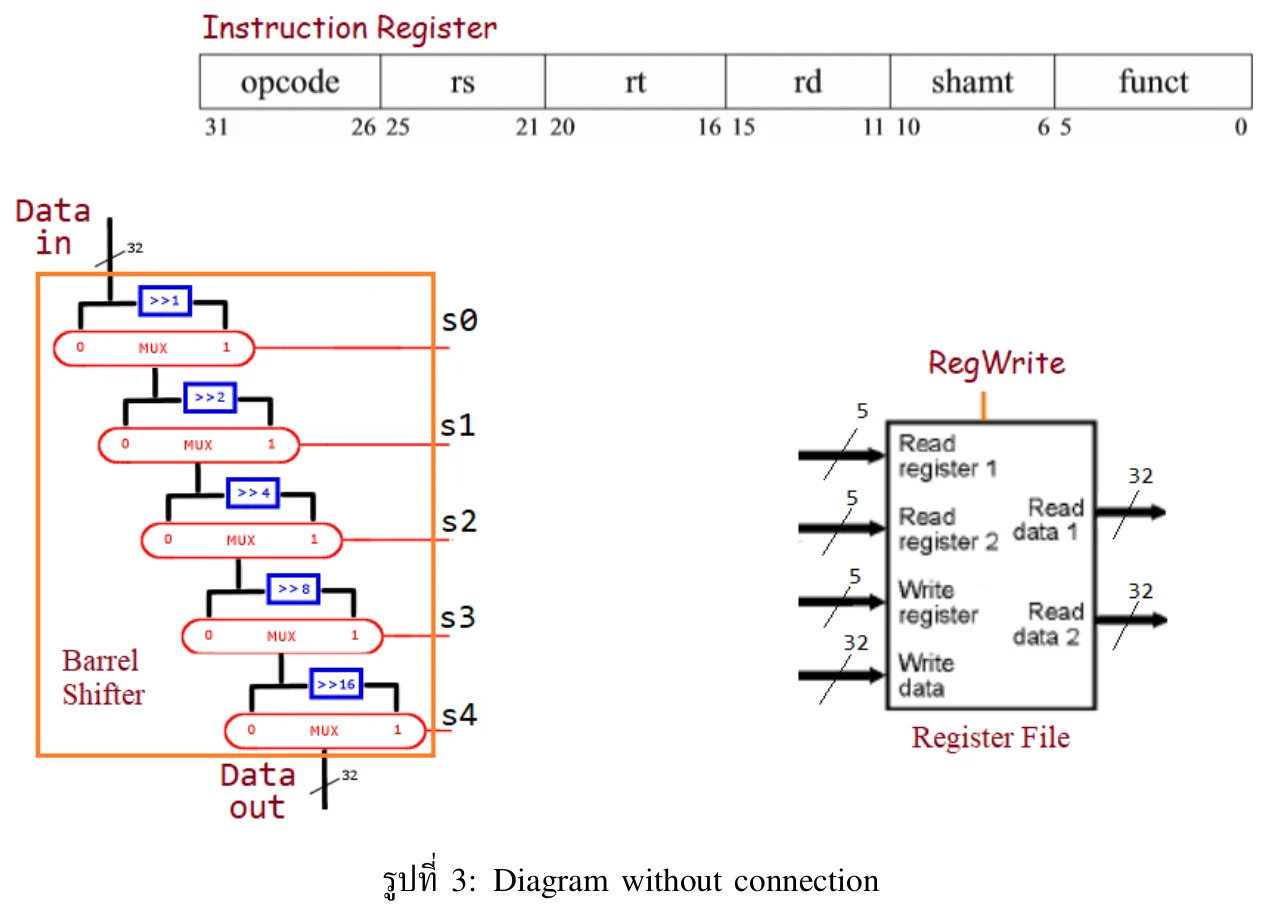
ให้ลากสายเชื่อม IR, Barrel Shifter และ Register File ให้ทำคำสั่ง srl ได้ พร้อมระบุบิตทุกเส้นที่คลุมเครือ — ข้อนี้มาจากส่วน “Version 3” ของบท multicycle ที่เพิ่มคำสั่ง sll/srl เข้าไป ตัวที่อาจารย์เปลี่ยนได้ง่ายคือชนิดคำสั่ง (sll, srlv) และลำดับชั้นของ shifter
ปูพื้นก่อนทำ: srl และ barrel shifterใครพร้อมแล้วข้ามได้
คำสั่ง srl
srl rd, rt, shamt ทำ R[rd] = R[rt] >> shamt (เลื่อนขวาแบบ logical เติม 0 ทางซ้าย) เป็น R-type: opcode = 0, rs = 0 (ไม่ใช้), rt = ค่าที่จะเลื่อน, rd = ปลายทาง, shamt = IR[10:6] คือจำนวนบิต, funct = 0x02
Barrel shifter เลื่อนได้ 0–31 บิตในทีเดียว
การเลื่อนคือการเดินสายใหม่ (rewiring) — เลื่อนขวา 1 บิตก็แค่ต่อบิต 1 ของ input ไปบิต 0 ของ output ต่อไปเรื่อยๆ แล้วเติม 0 · barrel shifter ต่อวงจรเลื่อนคงที่ 1, 2, 4, 8, 16 ไว้ 5 ชั้น แต่ละชั้นมี MUX เลือกว่าจะ “เลื่อน” หรือ “ผ่านตรง” · เลขใดๆ 0–31 เขียนเป็นผลบวกของ 1, 2, 4, 8, 16 ได้เสมอ (คือเลขฐานสอง 5 บิต) บิตที่ j ของ shamt จึงคุมชั้นที่เลื่อน 2j
ตัวอย่าง shamt = 13 = 01101₂ ⇒ ชั้น >>1 เลื่อน, >>2 ผ่าน, >>4 เลื่อน, >>8 เลื่อน, >>16 ผ่าน ⇒ รวม 1 + 4 + 8 = 13
Register file
มีพอร์ตอ่าน 2 ชุด (Read register → Read data) และพอร์ตเขียน 1 ชุด (Write register, Write data, RegWrite) — สาย register number กว้าง 5 บิต สาย data กว้าง 32 บิต
เนื้อหาเต็มอยู่ในบท Arithmetic for computers I สไลด์หน้า 35–36 และ Datapath and control II หน้า 8
วิธีคิดที่ใช้ได้ทุกเวอร์ชันไล่จาก RTL ของคำสั่ง
- เขียน RTL ของคำสั่ง จาก MIPS Ref. เช่น srl: R[rd] = R[rt] >> shamt แล้วแยกให้ได้ว่า “ค่าที่ถูกเลื่อน” “ระยะเลื่อน” และ “ปลายทาง” มาจาก field ไหน
- ค่าที่ถูกเลื่อน — field register (rt) → Read register ช่องใดช่องหนึ่ง → Read data ช่องเดียวกัน → Data in
- ระยะเลื่อน — แตกเป็นบิต แล้วจับคู่ บิตที่ j → MUX ของชั้นที่เลื่อน 2j ดูจากตัวเลขในกล่อง (>>1, >>2, …) ไม่ใช่ดูจากตำแหน่งชั้น — ถ้าอาจารย์สลับชั้น คำตอบเปลี่ยนตาม
- ปลายทาง — Data out → Write data · rd → Write register · RegWrite = 1
- กำกับบิตทุกเส้น — IR[20:16], IR[15:11], IR[6]…IR[10], 32-bit ฯลฯ ตามที่โจทย์สั่ง
เฉลยข้อสอบจริง (srl ตามรูปที่ 3)ใช้ Read register 2 / Read data 2 แทนได้
| ต่อจาก | ไปที่ | ขนาด |
|---|---|---|
| IR[20:16] (rt) | Read register 1 | 5 บิต |
| Read data 1 | Data in ของ barrel shifter | 32 บิต |
| IR[6] | s0 (ชั้น >>1) | 1 บิต |
| IR[7] | s1 (ชั้น >>2) | 1 บิต |
| IR[8] | s2 (ชั้น >>4) | 1 บิต |
| IR[9] | s3 (ชั้น >>8) | 1 บิต |
| IR[10] | s4 (ชั้น >>16) | 1 บิต |
| Data out | Write data | 32 บิต |
| IR[15:11] (rd) | Write register | 5 บิต |
| ค่าคงที่ 1 (จาก control) | RegWrite | 1 บิต |
ใน Lab ด้านล่าง กด “วาดสายเฉลย” เพื่อดูภาพการต่อสายแบบเดียวกับที่ต้องวาดในกระดาษ
ต้องจำเข้าห้องสอบ · ถ้าอาจารย์พลิกโจทย์
field ของ R-type
- op [31:26] · rs [25:21] · rt [20:16]
- rd [15:11] · shamt [10:6] · funct [5:0]
- srl funct = 0x02 · sll = 0x00 · srlv = 0x06 · sllv = 0x04
กฎของ shifter
- บิตที่ j ของระยะเลื่อน → ชั้นที่เลื่อน 2j
- shamt บิต j = IR[6 + j]
- MUX ขา “เลื่อน” ต้องได้ 1 เมื่อบิตนั้นเป็น 1 (ถ้าขาสลับ ต้องกลับบิต)
ถ้าเปลี่ยนโจทย์
- sll → ต่อเหมือน srl ทุกเส้น แค่ shifter เป็นแบบ <<
- srlv rd, rt, rs → rs → Read reg 1 · rt → Read reg 2 · Read data 2 → Data in · Read data 1 บิต [4:0] → s0–s4
- สลับลำดับชั้น → ดูเลขในกล่องแต่ละชั้น
- sra → shifter ต้องเติมบิตเครื่องหมาย (บิต 31) แทน 0
คำถาม 5 — Pipeline: เวลา และชื่อของปัญหา
10 คะแนน · ใช้ terminology ให้ถูก
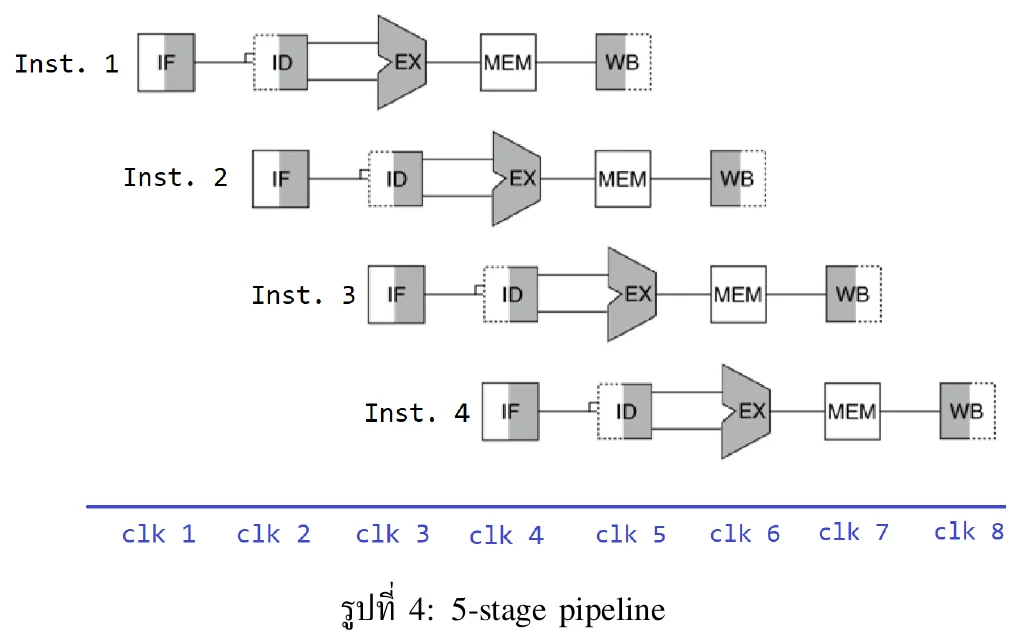
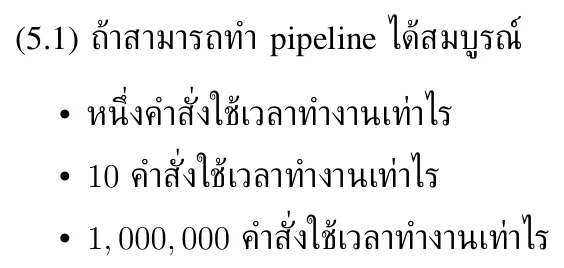
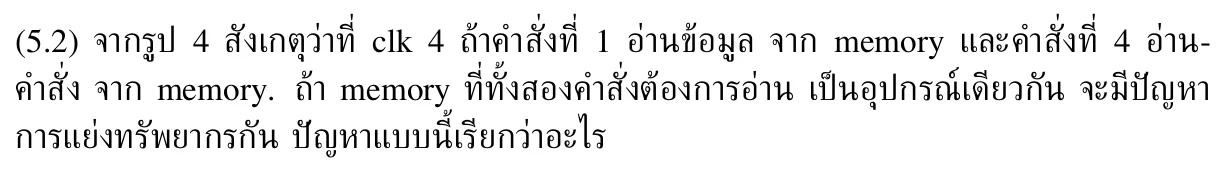
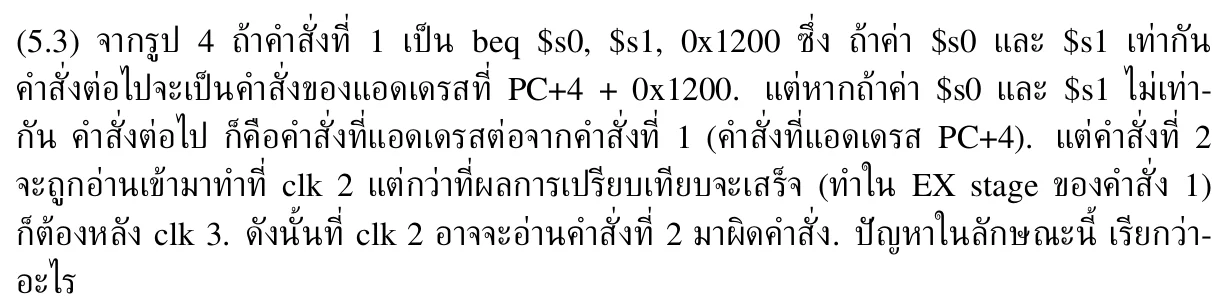
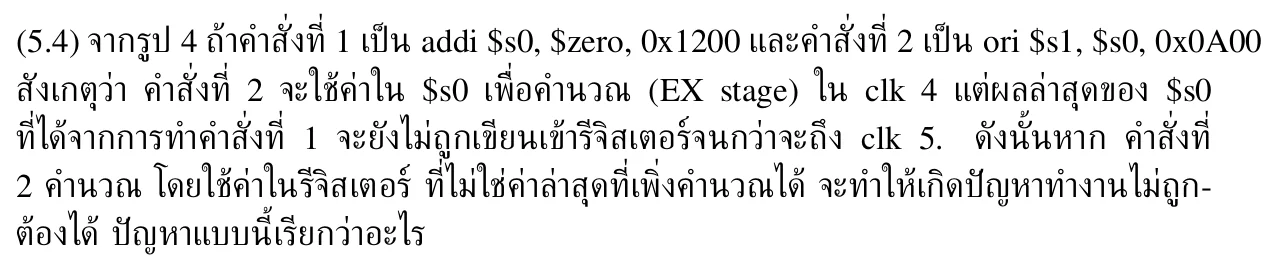
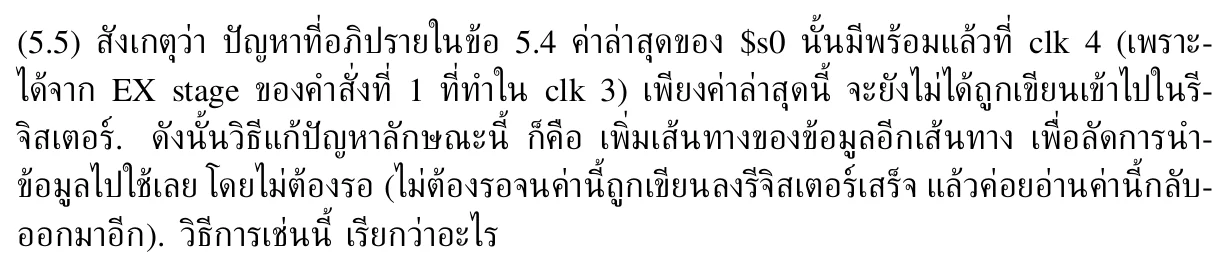
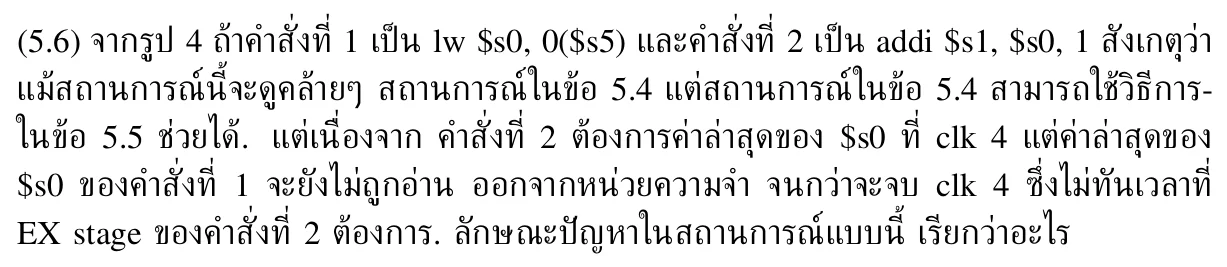
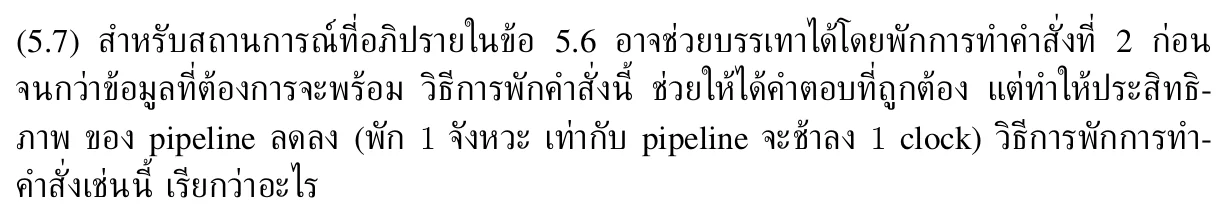
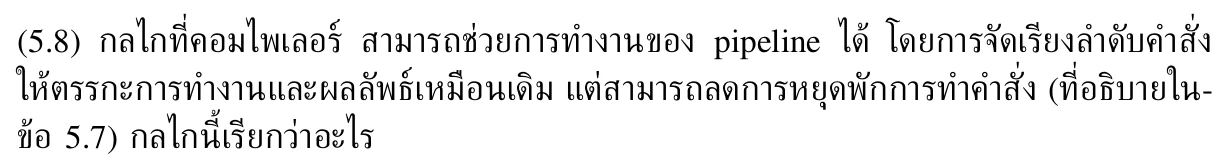
ข้อ 5.1 เป็นการคำนวณเวลา · ข้อ 5.2–5.10 ให้บอกชื่อของปัญหาหรือวิธีแก้จากสถานการณ์ — ตัวเลข register, clock หรือชนิดคำสั่งในโจทย์เปลี่ยนได้ แต่ชื่อที่ต้องตอบมีอยู่ไม่กี่คำ สิ่งที่ต้องฝึกคืออ่านสถานการณ์แล้วรู้ว่าเป็นแบบไหน
โจทย์ย่อยทั้ง 10 ข้อกดเพื่อดูภาพโจทย์จริง5.1–5.10


ปูพื้นก่อนทำ: pipeline และ hazard 3 แบบใครพร้อมแล้วข้ามได้
Pipeline คืออะไร
แบ่งการทำคำสั่งเป็น 5 stage — IF (fetch คำสั่ง) · ID (decode + อ่าน register) · EX (ALU) · MEM (อ่าน/เขียน data memory) · WB (เขียนผลกลับ register) แล้วให้หลายคำสั่งซ้อนเวลากันแบบซักผ้าทีละตะกร้า ตะกร้าแรกเข้าเครื่องอบ ตะกร้าที่สองก็เข้าเครื่องซักได้เลย
Latency ของคำสั่งเดียวไม่ได้ลดลง (ยังใช้ 5 clock) แต่ throughput เพิ่มขึ้นเป็นเกือบ 1 คำสั่งต่อ clock ⇒ speedup เข้าใกล้จำนวน stage เมื่อมีคำสั่งเยอะๆ
Hazard — สิ่งที่ทำให้ pipeline เดินเต็มที่ไม่ได้
| ชนิด | เกิดเพราะ | วิธีแก้ |
|---|---|---|
| Structural hazard | ฮาร์ดแวร์ชิ้นเดียว สองคำสั่งต้องใช้ใน clock เดียวกัน (เช่น memory ตัวเดียว) | เพิ่มฮาร์ดแวร์: แยก instruction/data memory หรือ I-cache/D-cache · หรือ stall |
| Data hazard | คำสั่งหลังต้องใช้ค่าที่คำสั่งก่อนหน้ายังเขียนไม่เสร็จ | Forwarding (bypassing) · ถ้าไม่ทัน (load-use) ต้อง stall · compiler ช่วยด้วย code scheduling |
| Control hazard | ยังไม่รู้ผลของ branch จึงไม่รู้ว่าต้อง fetch คำสั่งไหน | stall · ตัดสิน branch ให้เร็วขึ้น (ย้ายไป ID) · branch prediction แล้ว flush ถ้าเดาผิด |
ทำไม load-use ถึงแก้ด้วย forwarding อย่างเดียวไม่ได้
ALU คิดผลเสร็จตอนจบ EX จึงส่งต่อให้ EX ของคำสั่งถัดไปทันพอดี แต่ lw ได้ข้อมูลตอนจบ MEM ซึ่งเป็น clock เดียวกับที่คำสั่งถัดไปอยู่ใน EX แล้ว — ต้องส่งข้อมูล “ย้อนเวลา” ซึ่งทำไม่ได้ จึงต้องพักคำสั่งถัดไป 1 clock ก่อนแล้วค่อย forward
เนื้อหาเต็มอยู่ในบท Datapath and control III สไลด์หน้า 2–20 และ 37–64
วิธีคิดที่ใช้ได้ทุกเวอร์ชันตัวเลขกับ register เปลี่ยน แต่หลักไม่เปลี่ยน
- เวลา (5.1) — เวลา = (k + n − 1) × T เมื่อ k = จำนวน stage, n = จำนวนคำสั่ง, T = clock period (1 ÷ ความถี่) · คำสั่งเดียว = k × T
- มีคำว่า “แย่งใช้อุปกรณ์/หน่วยความจำตัวเดียวกัน” ⇒ Structural hazard
- มี branch/beq/jump และ “อาจ fetch ผิดคำสั่ง” ⇒ Control hazard (branch hazard)
- คำสั่งหลังใช้ register ที่คำสั่งก่อนหน้าเขียน ⇒ Data hazard · ถ้าคำสั่งก่อนหน้าเป็น
lwและอยู่ติดกัน ⇒ Load-use data hazard - ถามชื่อวิธีแก้ — ลัดเส้นทางข้อมูล = forwarding · พักคำสั่ง = stall · คอมไพเลอร์สลับคำสั่ง = code scheduling · เดาผล branch = branch prediction
เฉลยข้อสอบจริงตอบเป็นศัพท์ภาษาอังกฤษตามที่สอน
| ข้อ | คำตอบ | เหตุผลสั้นๆ |
|---|---|---|
| 5.1 | 1 คำสั่ง = 5 clock = 5 ns 10 คำสั่ง = 14 clock = 14 ns 1,000,000 คำสั่ง = 1,000,004 clock ≈ 1 ms | (5 + n − 1) × 1 ns · ถ้าใช้ period ตามที่โจทย์พิมพ์ (1 µs) ก็จะเป็น 5 µs, 14 µs, 1,000,004 µs — เขียนเป็นจำนวน clock กำกับไว้เสมอ |
| 5.2 | Structural hazard | MEM ของ Inst. 1 กับ IF ของ Inst. 4 ใช้ memory ตัวเดียวกันใน clk 4 |
| 5.3 | Control hazard (branch hazard) | ยังไม่รู้ผล beq แต่ต้อง fetch คำสั่งถัดไปแล้ว |
| 5.4 | Data hazard (RAW: read after write) | ori ต้องใช้ $s0 ก่อนที่ addi จะเขียนเสร็จ |
| 5.5 | Forwarding (bypassing) | ส่งผลจาก EX/MEM เข้า ALU ตรงๆ |
| 5.6 | Load-use data hazard | ข้อมูลจาก lw มาไม่ทัน EX ของคำสั่งถัดไป แม้มี forwarding |
| 5.7 | Stall (ใส่ bubble / pipeline interlock) | หยุดคำสั่งไว้ 1 clock |
| 5.8 | Code scheduling (instruction reordering) | คอมไพเลอร์สลับลำดับคำสั่งที่ไม่ขึ้นต่อกัน |
| 5.9 | Control hazard | เดาผล branch เพื่อไม่ต้องรอ |
| 5.10 | Structural hazard (การแย่งใช้หน่วยความจำ) | มี I-cache กับ D-cache แยกกัน IF กับ MEM จึงเข้าถึงพร้อมกันได้ และ cache ที่เร็วทำให้เข้าถึงหน่วยความจำเสร็จใน 1 clock |
ต้องจำเข้าห้องสอบ · ถ้าอาจารย์พลิกโจทย์
สูตรเวลา
- คำสั่งเดียว = k × T
- n คำสั่ง = (k + n − 1) × T
- ไม่ pipeline = n × k × T (ถ้าแต่ละ stage ยาว T)
- speedup → k เมื่อ n ใหญ่
- 1 GHz ⇒ 1 ns · 2 GHz ⇒ 0.5 ns · 500 MHz ⇒ 2 ns
ศัพท์ 8 คำ
- Structural / Data / Control hazard
- Load-use data hazard
- Forwarding (bypassing)
- Stall (bubble)
- Code scheduling
- Branch prediction (+ flush ถ้าเดาผิด)
ถ้าเปลี่ยนโจทย์
- lw แล้วคำสั่งถัดไปไม่ได้ใช้ค่านั้น → ไม่เกิด hazard
- lw ห่างกัน 2 คำสั่ง → forwarding จาก MEM/WB ทัน ไม่ต้อง stall
- ไม่มี forwarding → คำสั่งติดกันต้อง stall 2 clock
- branch ตัดสินที่ ID → เสีย 1 clock ถ้าเดาผิด (ที่ EX เสีย 2)
คำถาม 6 — ทำไม stage หลัง ID ได้สัญญาณควบคุมถูกตัว
10 คะแนน · เขียนในกระดาษ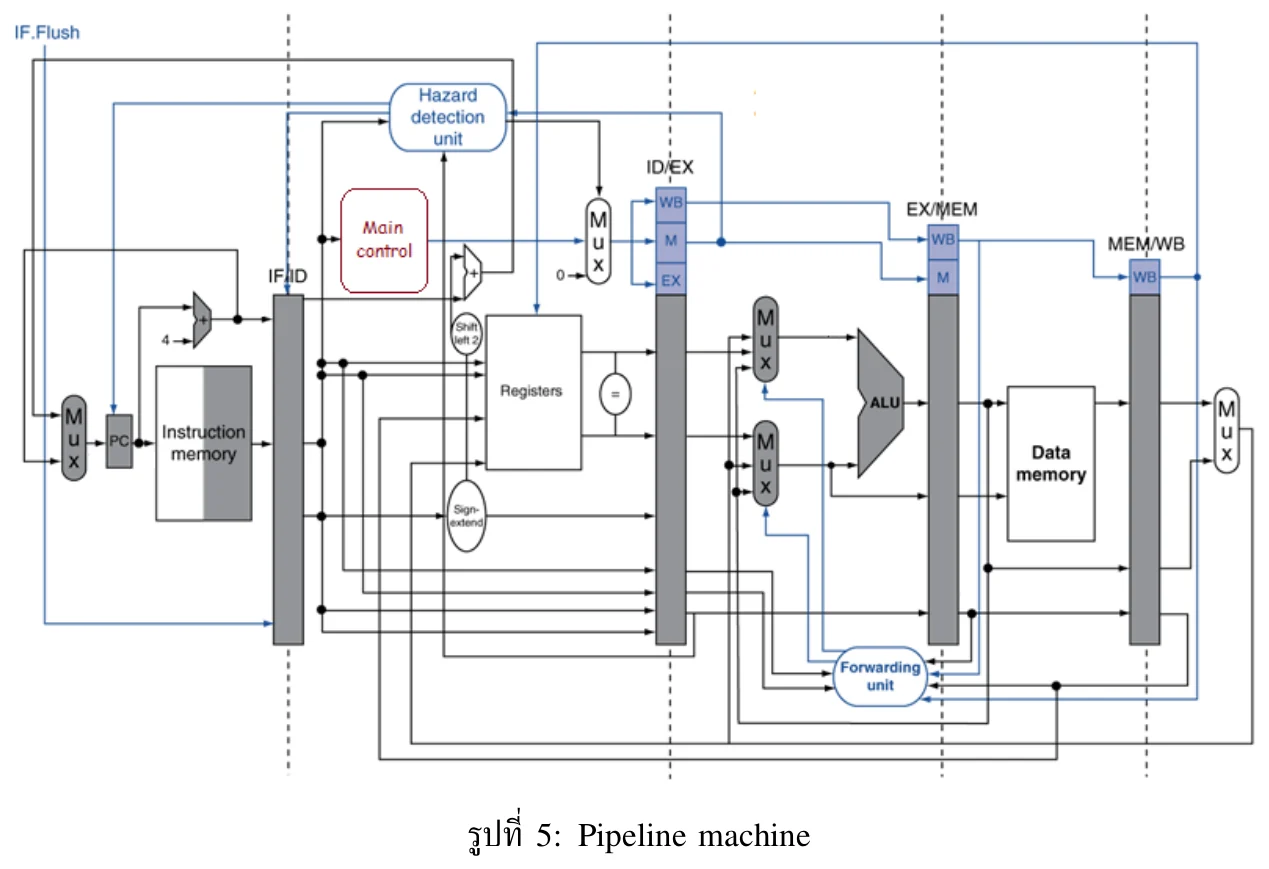
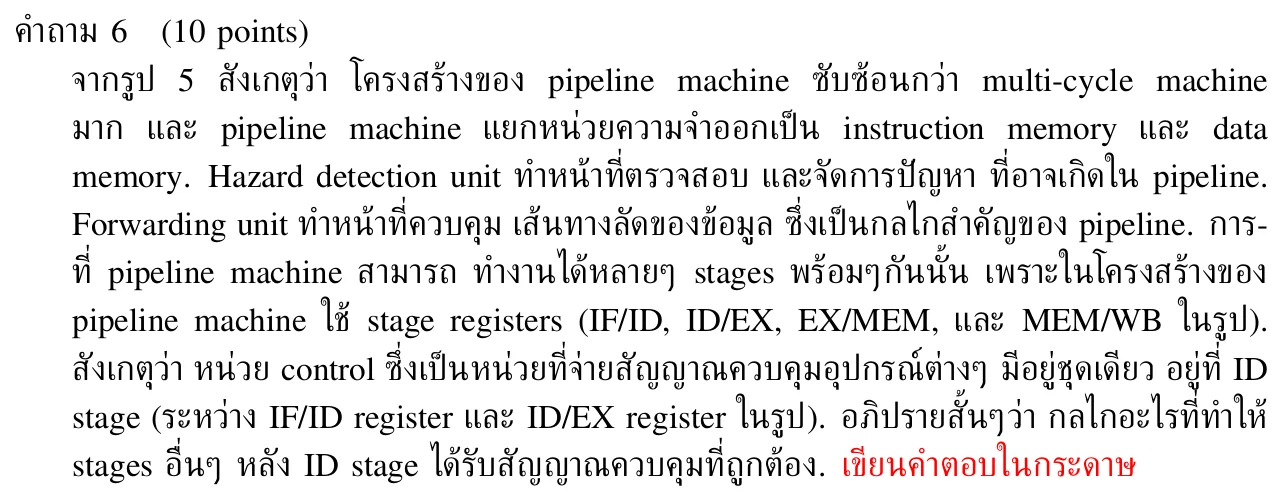
หน่วย control มีชุดเดียวอยู่ที่ ID แต่ pipeline ทำงาน 5 คำสั่งพร้อมกัน — โจทย์ถามว่าอะไรทำให้ EX, MEM, WB ได้สัญญาณของคำสั่งที่ตัวเองกำลังทำอยู่ ไม่ใช่ของคำสั่งที่อยู่ใน ID ตอนนั้น คำตอบสั้นแต่ต้องเขียนให้ครบกลไก
ปูพื้นก่อนทำ: pipeline register เก็บอะไรบ้างใครพร้อมแล้วข้ามได้
Pipeline register (IF/ID, ID/EX, EX/MEM, MEM/WB) คั่นระหว่าง stage ทุกคู่ ทำหน้าที่ “ถือ” ทุกอย่างที่คำสั่งนั้นยังต้องใช้ใน stage ถัดๆ ไป ทุก clock มันจะส่งของต่อไปข้างหน้าพร้อมกันทั้งหมด จึงทำงานหลาย stage พร้อมกันได้โดยข้อมูลไม่ปนกัน
| Register | ข้อมูลที่ถือ | สัญญาณควบคุมที่ถือ |
|---|---|---|
| IF/ID | คำสั่ง (instruction), PC + 4 | — (ยังไม่ decode) |
| ID/EX | ค่า Reg[rs], Reg[rt], immediate ที่ sign-extend แล้ว, เลข rs/rt/rd, PC + 4 | EX (RegDst, ALUOp, ALUSrc) · M · WB |
| EX/MEM | ผล ALU, Zero, branch target, ค่าที่จะ store, เลข register ปลายทาง | M (Branch, MemRead, MemWrite) · WB |
| MEM/WB | ข้อมูลที่อ่านจาก memory, ผล ALU, เลข register ปลายทาง | WB (RegWrite, MemtoReg) |
สังเกตว่าแม้แต่ เลข register ปลายทาง ก็ต้องเดินตามไปถึง MEM/WB — ถ้าใช้เลขจาก IF/ID ตอน WB จะได้เลขของคำสั่งอื่น (สไลด์ “Corrected Datapath for Load” แก้จุดนี้)
Hazard detection unit ตรวจ load-use แล้วสั่ง stall โดยบังคับสัญญาณควบคุมที่จะเข้า ID/EX เป็น 0 · Forwarding unit เทียบเลข register ใน EX/MEM, MEM/WB กับ ID/EX แล้วเลือกทางลัดให้ ALU
เนื้อหาเต็มอยู่ในบท Datapath and control III สไลด์หน้า 21–36 และ 47–56
วิธีเขียนตอบให้ได้เต็มเขียน 4 ประเด็นนี้ให้ครบ
- สร้างครั้งเดียว — control unit ถอดรหัส opcode ของคำสั่งตอนอยู่ ID แล้วสร้างสัญญาณควบคุมทุกตัวที่คำสั่งนั้นต้องใช้ในอนาคตทีเดียว
- เดินไปกับคำสั่ง — สัญญาณถูกเก็บลง pipeline register ไปพร้อมกับข้อมูลของคำสั่งนั้น แบ่งเป็นกลุ่ม EX, M, WB
- ใช้แล้วส่งต่อ — ที่ EX ใช้กลุ่ม EX แล้วส่ง M, WB ไป EX/MEM · ที่ MEM ใช้ M แล้วส่ง WB ไป MEM/WB · ที่ WB ใช้ WB
- สรุป — แต่ละ stage อ่าน control จาก pipeline register ข้างหน้าตัวเอง ซึ่งเป็นของคำสั่งที่อยู่ใน stage นั้นพอดี จึงได้สัญญาณถูกตัวเสมอ แม้ 5 stage ทำคนละคำสั่งพร้อมกัน
ตัวอย่างคำตอบที่เขียนในกระดาษยาวประมาณนี้พอ
ดังนั้นแต่ละ stage ใช้สัญญาณจาก pipeline register ที่อยู่ข้างหน้าตัวเอง ซึ่งเป็นของคำสั่งที่กำลังทำอยู่ใน stage นั้น สัญญาณจึงถูกต้องแม้แต่ละ stage ทำคนละคำสั่งพร้อมกัน
ถ้าอาจารย์พลิกโจทย์ข้อ 6คำถามเขียนอธิบายที่อาจเจอแทน
EX/MEM เก็บสัญญาณควบคุมอะไรบ้าง และทำไมไม่มีกลุ่ม EX
ทำไมไม่สร้างสัญญาณควบคุมใหม่ที่แต่ละ stage
เวลาเกิด load-use hazard สัญญาณควบคุมถูกจัดการยังไง
เลข register ปลายทาง (rd/rt) ต้องเดินไปด้วยไหม
IF.Flush ในรูปที่ 5 ใช้ทำอะไร
Forwarding unit ต้องรู้อะไรจาก pipeline register
ทำไม pipeline machine ต้องแยก instruction memory กับ data memory
ซ้อมรวม + สิ่งที่ต้องจำ
ทวนก่อนเข้าห้องสอบข้อ 1 · Arithmetic
- 4 บิต: unsigned 0…15 · signed −8…7
- unsigned + overflow ⇔ carry out
- signed + overflow ⇔ เครื่องหมายเหมือนกันแต่ผลกลับ
- A − B = A + ~B + 1
ข้อ 2 · ALU control
- and 0,0,x,00 · or 0,0,x,01
- add 0,0,0,10 · sub 0,1,1,10
- nor 1,1,x,00 · slt 0,1,1,11
- (Ainv, Binv, CarryIn, Op) — ถ้าสายย้าย ไล่ใหม่
ข้อ 3 · Multicycle
- S0 fetch: IorD 0, MemRead, IRWrite, SrcA 0, SrcB 01, ALUOp 00, PCSource 00, PCWrite
- S1: R (1,00,10) · lw/sw (1,10,00) · beq (0,11,00) · j (PCSource 10, PCWrite)
- S2: R (RegDst 1, RegWrite) · lw (IorD 1, MemRead, MemtoReg 1, RegWrite) · sw (IorD 1, MemWrite) · beq (1,00,01, PCSource 01, PCWriteCond)
ข้อ 4 · srl
- rt → Read reg → Read data → Data in
- IR[6+j] → MUX ของชั้นที่เลื่อน 2j
- Data out → Write data · rd → Write reg · RegWrite = 1
ข้อ 5 · Pipeline
- เวลา = (k + n − 1) × T
- Structural / Data / Control hazard
- Forwarding · Load-use · Stall · Code scheduling · Branch prediction
ข้อ 6 · Pipelined control
- สร้างที่ ID ครั้งเดียว
- ID/EX: EX M WB → EX/MEM: M WB → MEM/WB: WB
- แต่ละ stage ใช้กลุ่มของตัวเองแล้วส่งที่เหลือต่อ
ถาม–ตอบเร็ว (กดเพื่อดูคำตอบ)
0b1100 + 0b0101 แบบ unsigned 4 บิต overflow ไหม แล้วแบบ signed ล่ะ
0b0111 − 0b1111 แบบ signed 4 บิต
ถ้า MUX ผลลัพธ์ของ ALU เรียง 0 = +, 1 = AND, 2 = Less, 3 = OR — NOR ต้องตั้ง Operation เท่าไร
ถ้า ALUSrcB สลับเป็น 0 = 4, 1 = Reg[rt] — state 0 ต้องตั้ง ALUSrcB เท่าไร
beq ในเครื่อง 3 state ใช้ ALU กี่ครั้ง ทำอะไรบ้าง
sll ต่อสายต่างจาก srl ตรงไหน
6-stage pipeline clock 2 GHz รัน 100 คำสั่งแบบไม่มี hazard ใช้เวลาเท่าไร
lw $t0, 0($s0) แล้วคำสั่งถัดไป add $t1, $t0, $t2 มี forwarding ต้อง stall กี่ clock
ถ้าไม่มี forwarding add แล้วคำสั่งถัดไปใช้ผลทันที ต้อง stall กี่ clock
bubble ต่างจาก flush ยังไง
เนื้อหาที่ออกสอบ 5 บท
สไลด์ทุกหน้า + อธิบายภาษาไทยข้อสอบแต่ละข้อมาจากบทเหล่านี้ — ข้อ 1–2 และ 4 จาก Arithmetic I · ข้อ 3 จาก Datapath II · ข้อ 5–6 จาก Datapath III · บทที่เหลือเป็นพื้นฐานที่ต้องเข้าใจก่อน